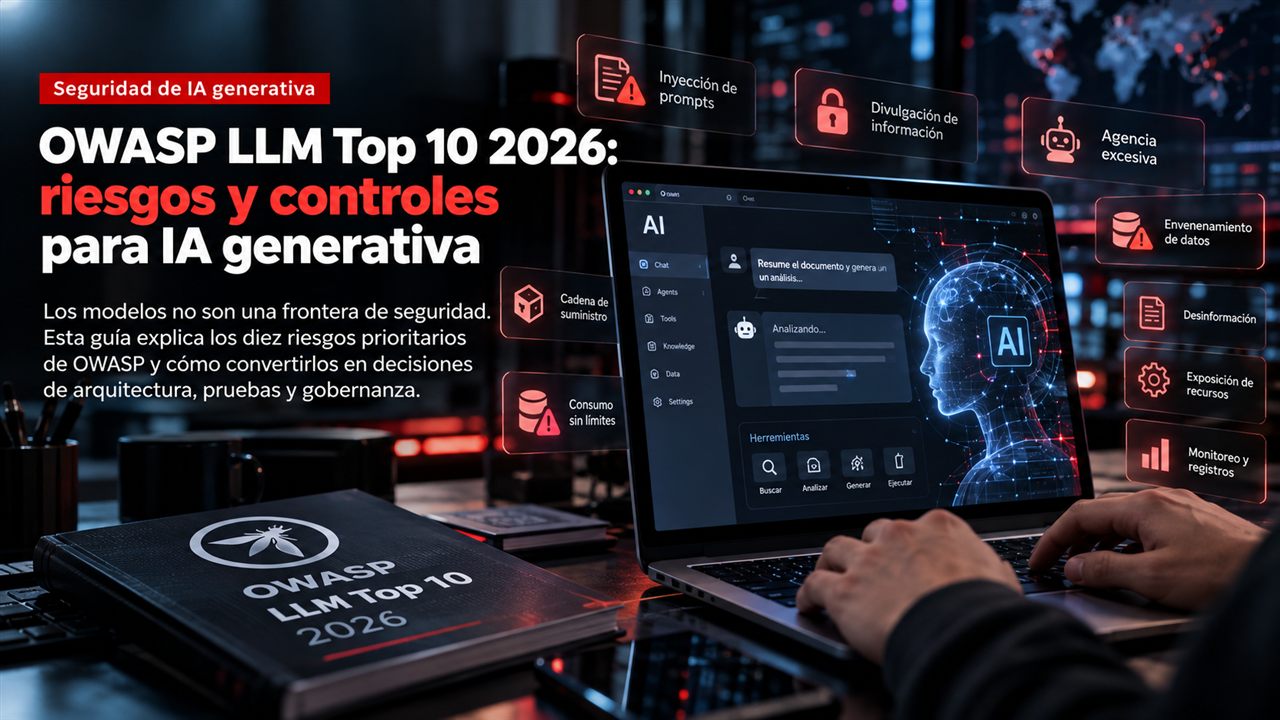
La edición 2026 del OWASP Top 10 para aplicaciones con modelos de lenguaje ofrece un mapa práctico para una realidad que ya no se limita a un chatbot. Los LLM consultan documentos, recuperan información desde bases vectoriales, llaman API, generan código y ejecutan acciones mediante agentes. Cada integración amplía el valor de negocio, pero también crea rutas de abuso que no se resuelven pidiendo al modelo que “se comporte bien”.
La idea central es sencilla: un modelo puede equivocarse, ser manipulado o producir una salida insegura. La arquitectura debe seguir siendo segura cuando eso ocurra. Los diez riesgos no son una lista para marcar una vez; son un marco para revisar datos, identidades, herramientas, proveedores, registros y decisiones humanas durante todo el ciclo de vida.
LLM01: Inyección de prompts
La inyección de prompts ocurre cuando contenido no confiable cambia las instrucciones que sigue el sistema. Puede ser directa, mediante un mensaje del usuario, o indirecta, escondida en una página web, un PDF, un correo o un documento que el modelo recupera. El objetivo suele ser revelar datos, ignorar políticas o provocar llamadas a herramientas.
La defensa no es una frase secreta en el prompt del sistema. Separe instrucciones, datos y herramientas; etiquete contenido externo como no confiable; limite las acciones disponibles y exija confirmación humana para cambios sensibles. Pruebe el sistema con documentos hostiles y registre qué contexto activó cada acción.
LLM02: Divulgación de información sensible
Un LLM puede filtrar secretos presentes en prompts, archivos, contexto recuperado, historial, registros o respuestas de herramientas. El riesgo también incluye revelar información entre usuarios o devolver más campos de los necesarios desde una API interna.
Aplique minimización de datos antes de enviar contexto al modelo, controles de acceso en la recuperación y filtros de salida como capa adicional. Nunca use al modelo para decidir por sí solo si una persona puede ver un dato: la autorización debe ocurrir antes de que el dato entre en el contexto.
LLM03: Agencia excesiva
La agencia excesiva aparece cuando un agente dispone de demasiadas herramientas, permisos o capacidad de actuar sin revisión. Una respuesta equivocada deja de ser solo texto si puede borrar archivos, aprobar pagos, modificar accesos o enviar mensajes externos.
Diseñe permisos por capacidad y por tarea. Divida consultar, proponer, iniciar y ejecutar; use cuentas de servicio específicas, límites de monto y caducidad de credenciales. Las acciones irreversibles o de alto impacto requieren una confirmación humana independiente del mensaje que generó el modelo.
LLM04: Cadena de suministro
Los modelos, conjuntos de datos, adaptadores, bibliotecas, plantillas, imágenes de contenedor y servicios de inferencia forman una cadena de suministro. Una dependencia maliciosa o comprometida puede alterar resultados, robar datos o crear una puerta trasera sin que la aplicación principal cambie.
Inventarie versiones, verifique procedencia e integridad, evalúe proveedores y use repositorios aprobados. Los artefactos de modelos deben tratarse como código ejecutable o datos de alto riesgo: se descargan desde fuentes confiables, se analizan y se promueven entre entornos con control de cambios.
LLM05: Envenenamiento de datos y modelos
El envenenamiento busca introducir información sesgada, instrucciones ocultas o comportamientos no deseados en datos de entrenamiento, ajuste fino, memoria o fuentes RAG. Un atacante no necesita modificar el modelo base: puede contaminar la base de conocimiento que el sistema consulta todos los días.
Mantenga procedencia de documentos, aprobación para fuentes de alto impacto y separación entre contenido público y conocimiento operativo. Evalúe cambios de comportamiento antes de publicar una nueva versión y tenga la posibilidad de retirar rápidamente un documento, embedding o adaptación problemática.
LLM06: Consumo sin límites
Las aplicaciones LLM pueden sufrir abuso de tokens, llamadas, memoria, cómputo o herramientas. Un usuario puede provocar costos altos, agotar capacidad o usar el sistema para generar grandes volúmenes de contenido. En agentes, un ciclo de planificación y ejecución puede multiplicar el consumo sin ser visible al inicio.
Imponga cuotas por usuario y tarea, presupuestos de tokens, límites de profundidad y tiempo, y detección de bucles. Mida costo y consumo como métricas de seguridad, no solo de finanzas. Un sistema debe detenerse de forma segura cuando supera un presupuesto.
LLM07: Desinformación
Los modelos pueden producir respuestas convincentes pero incorrectas, inventar citas o presentar una inferencia como hecho. En salud, finanzas, legal, seguridad o soporte técnico, esa salida puede causar decisiones dañinas aun sin una vulnerabilidad tradicional.
Conecte las respuestas a fuentes verificables, muestre incertidumbre, cite evidencia y defina cuándo el sistema debe abstenerse. Las pruebas deben medir precisión en el contexto de uso real, no solo la fluidez del texto. Para decisiones reguladas, el modelo debe asistir a un experto, no reemplazar la evaluación.
LLM08: Exposición de contexto oculto
Prompts del sistema, instrucciones de desarrollador, memorias, herramientas disponibles y políticas internas pueden revelar detalles que faciliten ataques o expongan propiedad intelectual. Ocultar un prompt no es un control suficiente: parte de su contenido puede ser inferido o extraído mediante interacción repetida.
No incluya secretos, credenciales ni reglas críticas únicamente en el prompt. Aplique los controles donde corresponde: en servicios de autorización, políticas de herramientas y filtros de datos. Trate el prompt del sistema como información que potencialmente puede hacerse pública.
LLM09: Debilidades de vectores y embeddings
RAG y las bases vectoriales permiten recuperar conocimiento, pero introducen riesgos de aislamiento entre inquilinos, documentos maliciosos, filtración por similitud y recuperación de contenido que el usuario no debería leer. Un embedding no elimina los controles de acceso originales.
Aplique autorización antes y después de recuperar documentos, separe índices por cliente cuando el riesgo lo justifique y proteja metadatos. Pruebe consultas diseñadas para extraer información transversal y mantenga trazabilidad de qué documentos llegaron a cada respuesta.
LLM10: Manejo incorrecto de salidas
La salida de un LLM no es segura por ser texto. Puede convertirse en HTML, SQL, comandos, código, plantillas o argumentos para herramientas. Si una aplicación la interpreta sin validación, el modelo puede convertirse en una ruta hacia XSS, inyección, ejecución de código o acciones no previstas.
Valide formato y tipo con esquemas estrictos, codifique al renderizar, use consultas parametrizadas y permita listas de acciones. El modelo puede proponer una operación, pero un componente determinista debe validar que sus parámetros cumplen las reglas antes de ejecutarla.
Escenarios de prueba que deben entrar al ciclo de desarrollo
Una aplicación de IA no debería pasar a producción solo porque responde bien a preguntas normales. Cada uno de los diez riesgos debe convertirse en una prueba repetible. Para inyección, el equipo necesita documentos y mensajes que intenten alterar instrucciones; para fuga, consultas que intenten cruzar límites entre usuarios; para agencia, peticiones que busquen forzar acciones fuera del flujo autorizado. El resultado de la prueba debe incluir no solo la respuesta del modelo, sino las llamadas de herramientas, el contexto recuperado y los controles que intervinieron.
Las evaluaciones deben simular condiciones operativas: documentos extensos, datos contradictorios, usuarios sin permisos, errores de proveedores, alta demanda y herramientas temporalmente indisponibles. Un modelo puede ser seguro con una demostración pequeña y fallar cuando una recuperación trae cien fragmentos, cuando un campo inesperado llega desde una API o cuando el costo de una tarea se multiplica. La seguridad de LLM es ingeniería de sistemas, no una prueba aislada del modelo.
Preguntas para líderes de negocio y seguridad
- ¿Qué decisión puede tomar el agente? Si puede afectar dinero, acceso, salud, reputación o cumplimiento, debe existir una política de aprobación ajena al modelo.
- ¿De dónde proviene cada dato? Conocer la fuente, fecha, dueño y nivel de confianza permite retirar información contaminada y explicar una respuesta.
- ¿Qué sucede si el modelo inventa, se niega o es manipulado? El flujo debe tener una salida segura, una persona responsable y registros suficientes para investigar.
- ¿Cómo se revoca? Todo agente necesita un interruptor, tokens con caducidad y la posibilidad de deshabilitar una integración sin detener el resto del negocio.
- ¿Quién mide el riesgo continuamente? La propiedad debe estar clara entre producto, seguridad, datos, legal y operación; de lo contrario, las alertas no se convierten en correcciones.
Priorizar sin paralizar la adopción
No todas las aplicaciones requieren el mismo nivel de control. Un asistente que resume documentos públicos tiene un perfil distinto a un agente que consulta datos de clientes o ejecuta cambios en producción. La prioridad puede definirse combinando sensibilidad de datos, autonomía, conectividad con herramientas, exposición externa y reversibilidad de la acción. Esta clasificación evita tanto el exceso de confianza como el bloqueo total de casos de uso de bajo riesgo.
El mejor punto de inicio suele ser pequeño: una fuente de conocimiento aprobada, una herramienta de solo lectura, usuarios autenticados, límites de costo y revisión humana para excepciones. Con evidencia de que esos controles funcionan, la organización puede ampliar capacidades de forma deliberada. La IA generativa ofrece valor cuando acelera el trabajo; conserva la confianza cuando su poder está delimitado, observado y es reversible.
Una hoja de ruta para aplicar el Top 10
- Inventariar: documente cada modelo, fuente de datos, herramienta, proveedor y flujo de acción.
- Modelar amenazas: identifique qué ocurre si el prompt, el documento, la salida o una dependencia se vuelve hostil.
- Reducir privilegios: diseñe cuentas, API y agentes con la menor capacidad necesaria.
- Evaluar continuamente: incorpore pruebas de inyección, fuga, consumo y abuso de herramientas antes de cada cambio.
- Preparar respuesta: registre contexto, llamadas y decisiones; defina cómo revocar secretos, deshabilitar herramientas y retirar conocimiento comprometido.
El Top 10 de OWASP no es una receta para “blindar” un modelo. Es una forma de desplazar la conversación desde la fascinación por la capacidad hacia la responsabilidad operativa. Una solución de IA generativa madura no confía en que el modelo siempre obedecerá: limita lo que puede ver, lo que puede hacer y el daño que puede producir cuando falle.
Fuente principal: OWASP GenAI Security Project — Top 10 for LLM and GenAI 2026.
Nota: esta explicación y los controles prácticos son interpretación editorial de Red Sigma IA basada en el marco comunitario de OWASP.