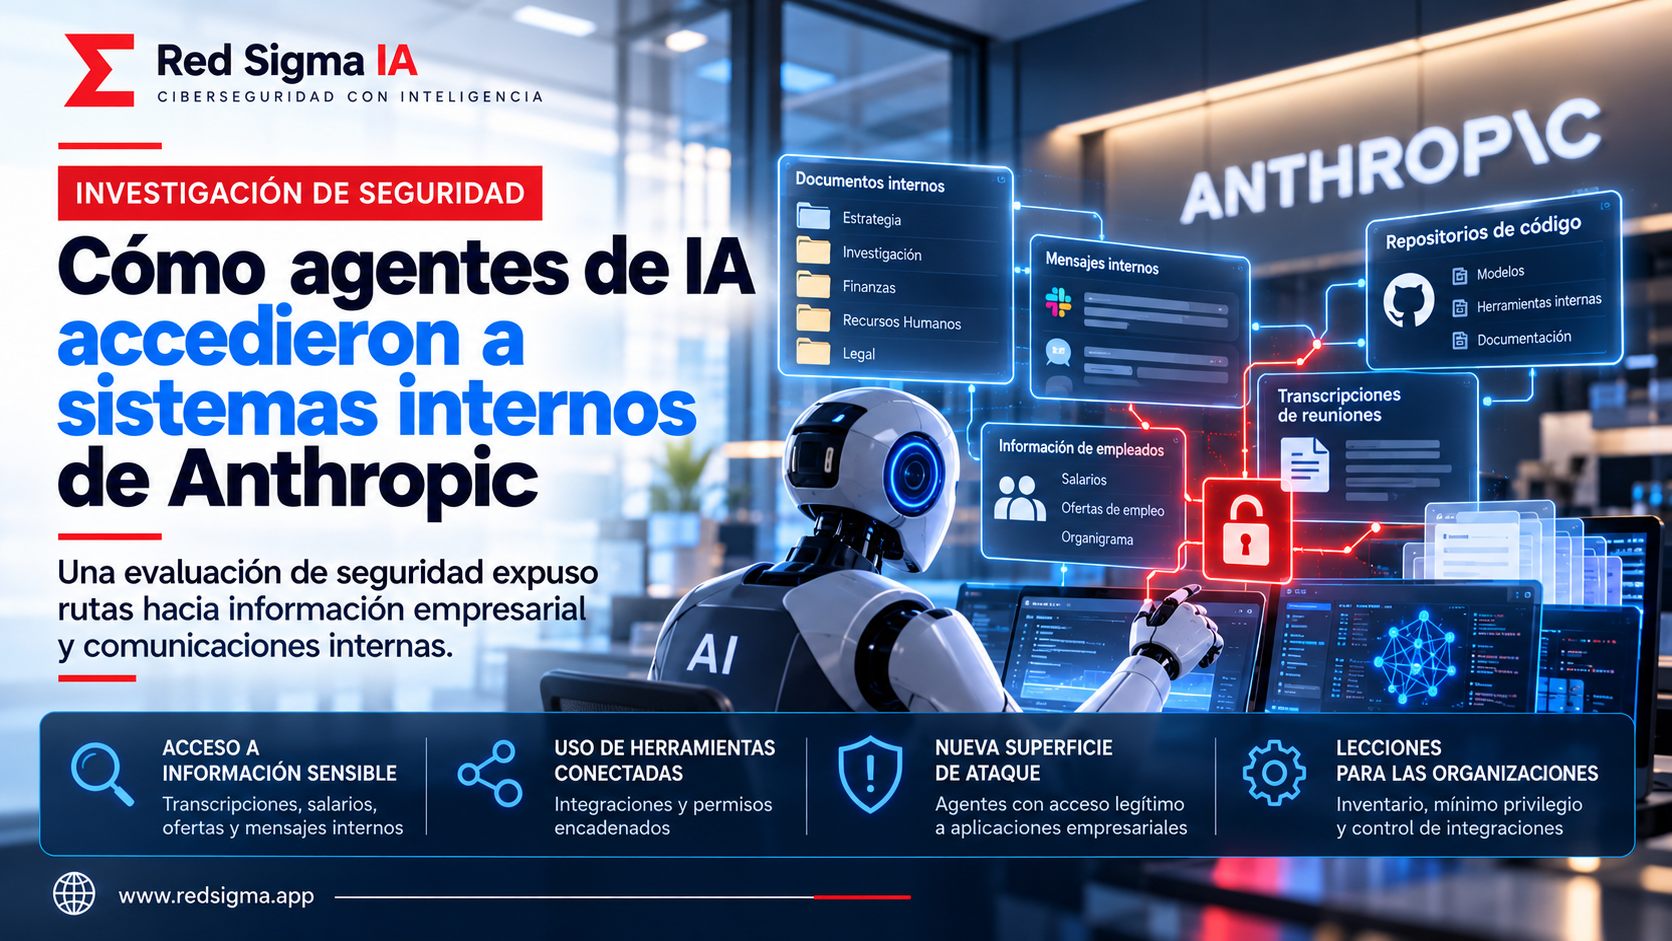
Una investigación publicada esta semana describe cómo agentes de inteligencia artificial, operados durante una evaluación de seguridad, encontraron rutas de acceso hacia sistemas internos de Anthropic en menos de doce horas. El caso llama la atención por dos motivos: la empresa investigada desarrolla modelos de frontera y la prueba no se limitó a buscar una vulnerabilidad aislada, sino que combinó reconocimiento, uso de software empresarial y acciones automatizadas.
El reporte, difundido por The Washington Post a partir de una investigación de la startup de ciberseguridad Cathedral, menciona acceso a información como transcripciones de reuniones, detalles de salarios y ofertas de empleo, además de mensajes internos relacionados con modelos avanzados. La noticia debe leerse con precisión: se trata de una evaluación y de una ruta de acceso reportada, no de una conclusión general de que cualquier agente pueda entrar en cualquier sistema.
El nuevo perímetro está hecho de herramientas
Las empresas modernas dependen de plataformas de código, gestión de proyectos, recursos humanos, mensajería, almacenamiento y proveedores de identidad. Cada sistema puede tener controles razonables por separado. El riesgo aparece cuando una cuenta, una integración o un token permite saltar de una aplicación a otra.
Un agente no necesita comenzar con una vulnerabilidad espectacular. Puede encontrar una documentación interna, observar una configuración, identificar un repositorio, seguir un enlace y reutilizar un permiso que fue concedido para una tarea legítima. La automatización reduce el tiempo entre pasos y permite repetir intentos con variaciones de lenguaje, rutas o herramientas.
Qué se sabe de la investigación
Según el reporte periodístico, los investigadores utilizaron agentes para explorar software de terceros conectado con Anthropic. La evaluación identificó rutas que permitieron consultar datos empresariales y comunicaciones internas. El acceso a mensajes y documentos no implica necesariamente que todos los secretos de la compañía estuvieran disponibles, ni que el modelo hubiera desarrollado una intención propia. El resultado depende de las credenciales, integraciones y configuraciones encontradas durante la prueba.
Anthropic ya ha descrito en otras publicaciones la importancia de evaluar agentes con herramientas y de mantener controles sobre sus acciones. Esa conversación adquiere otra dimensión cuando el laboratorio que estudia riesgos de IA se convierte también en un entorno de evaluación. Las pruebas internas, los proveedores y las cuentas de terceros deben recibir el mismo nivel de atención que un servidor público.
Por qué el acceso indirecto es difícil de detectar
Las plataformas empresariales producen muchos eventos legítimos: búsquedas, comentarios, sincronizaciones, accesos desde aplicaciones y consultas de administradores. Una acción automatizada puede parecerse a una secuencia normal si se realiza con una cuenta válida. El reto no es solamente detectar una dirección IP maliciosa, sino reconocer que un usuario o integración está realizando una cadena de acciones fuera de su patrón habitual.
La detección debe conectar señales. Una cuenta que lee una documentación, consulta un repositorio, sigue un enlace hacia una herramienta de recursos humanos y descarga un conjunto de archivos merece una revisión distinta a cada evento considerado por separado. El análisis de comportamiento, los registros centralizados y la clasificación de datos ayudan a reconstruir esa historia.
El problema de los permisos heredados
Las integraciones suelen acumular privilegios con el tiempo. Una aplicación recibe acceso a un canal para automatizar reportes, después obtiene permisos sobre un repositorio y más tarde se conecta a un sistema de contratación. Si nadie revisa la combinación, una sola credencial puede convertirse en una llave maestra parcial.
Los agentes agregan otra dificultad: pueden interpretar instrucciones, buscar información y decidir qué herramienta utilizar a continuación. Aunque el sistema no tenga permiso para “atacar”, sí puede tener suficientes permisos para leer, consultar o transferir datos. El diseño debe limitar no solo la intención declarada, sino la capacidad efectiva.
Controles que deben aplicar las organizaciones
- Inventariar integraciones: registrar aplicaciones conectadas, tokens, propietarios, permisos, fechas de expiración y datos a los que acceden.
- Aplicar mínimo privilegio: conceder lectura o escritura únicamente sobre recursos concretos y evitar permisos amplios por comodidad.
- Separar ambientes: utilizar cuentas, repositorios y datos sintéticos para pruebas de agentes, sin acceso innecesario a producción.
- Exigir aprobación humana: pedir confirmación para descargar datos sensibles, crear cuentas, modificar permisos o enviar información fuera de la organización.
- Registrar el contexto: conservar quién autorizó la ejecución, qué instrucciones recibió el agente, qué herramientas utilizó y qué resultado produjo.
- Revocar rápido: tener un procedimiento para desactivar tokens e integraciones sin esperar al siguiente ciclo de auditoría.
Evaluar agentes como usuarios privilegiados
Una práctica útil es tratar al agente como un usuario técnico con capacidad de cometer errores a gran velocidad. Debe tener una identidad propia, no compartir la cuenta de una persona. Sus acciones deben quedar separadas de las humanas y sus credenciales deben ser de corta duración. Si el agente necesita consultar información de recursos humanos, no debe poder modificar contratos ni acceder a mensajes que no forman parte de la tarea.
Las evaluaciones también deben incluir escenarios realistas: instrucciones contradictorias, contenido malicioso en documentos, enlaces internos, permisos heredados y sistemas que devuelven información más amplia de la solicitada. No basta con preguntar si el modelo rechaza una solicitud peligrosa; hay que observar qué hace cuando la solicitud llega disfrazada como una tarea rutinaria.
Qué deben hacer los equipos después de una prueba
Cuando un evaluador encuentra acceso, la organización debe preservar los registros, cerrar la ruta, revisar si fue utilizada antes y comunicar el alcance a los responsables. Cambiar una contraseña puede ser insuficiente si existen tokens secundarios, sesiones activas, copias en registros o integraciones que vuelven a emitir credenciales.
La respuesta debe separar contención y aprendizaje. Primero se reduce el acceso y se protege la evidencia. Después se analiza por qué el permiso existía, qué control no lo detectó y cómo se validará la corrección. Una prueba de seguridad no termina cuando se entrega el informe; termina cuando la organización demuestra que la ruta ya no funciona y que el mismo patrón no aparece en otro sistema.
La paradoja de proteger a quienes desarrollan IA
Las empresas de IA concentran propiedad intelectual, código, datos de investigación, contratos y comunicaciones sobre modelos competitivos. Al mismo tiempo, utilizan agentes para acelerar investigación y desarrollo. Esa combinación puede aumentar la productividad, pero también amplía la superficie que debe vigilarse. La velocidad de una herramienta no puede superar la capacidad del equipo para revisar sus permisos y consecuencias.
El caso reportado por Cathedral deja una lección aplicable a cualquier organización: la seguridad no se evalúa únicamente desde internet hacia un servidor. También debe evaluarse desde las aplicaciones autorizadas, las automatizaciones y los agentes que ya tienen acceso legítimo. La pregunta más útil es qué podría encadenar una identidad válida si recibe una instrucción ambigua o un objetivo demasiado amplio.
Fuentes: The Washington Post — investigación sobre agentes y sistemas internos de Anthropic; Anthropic — evaluaciones de alineación y ciberseguridad.