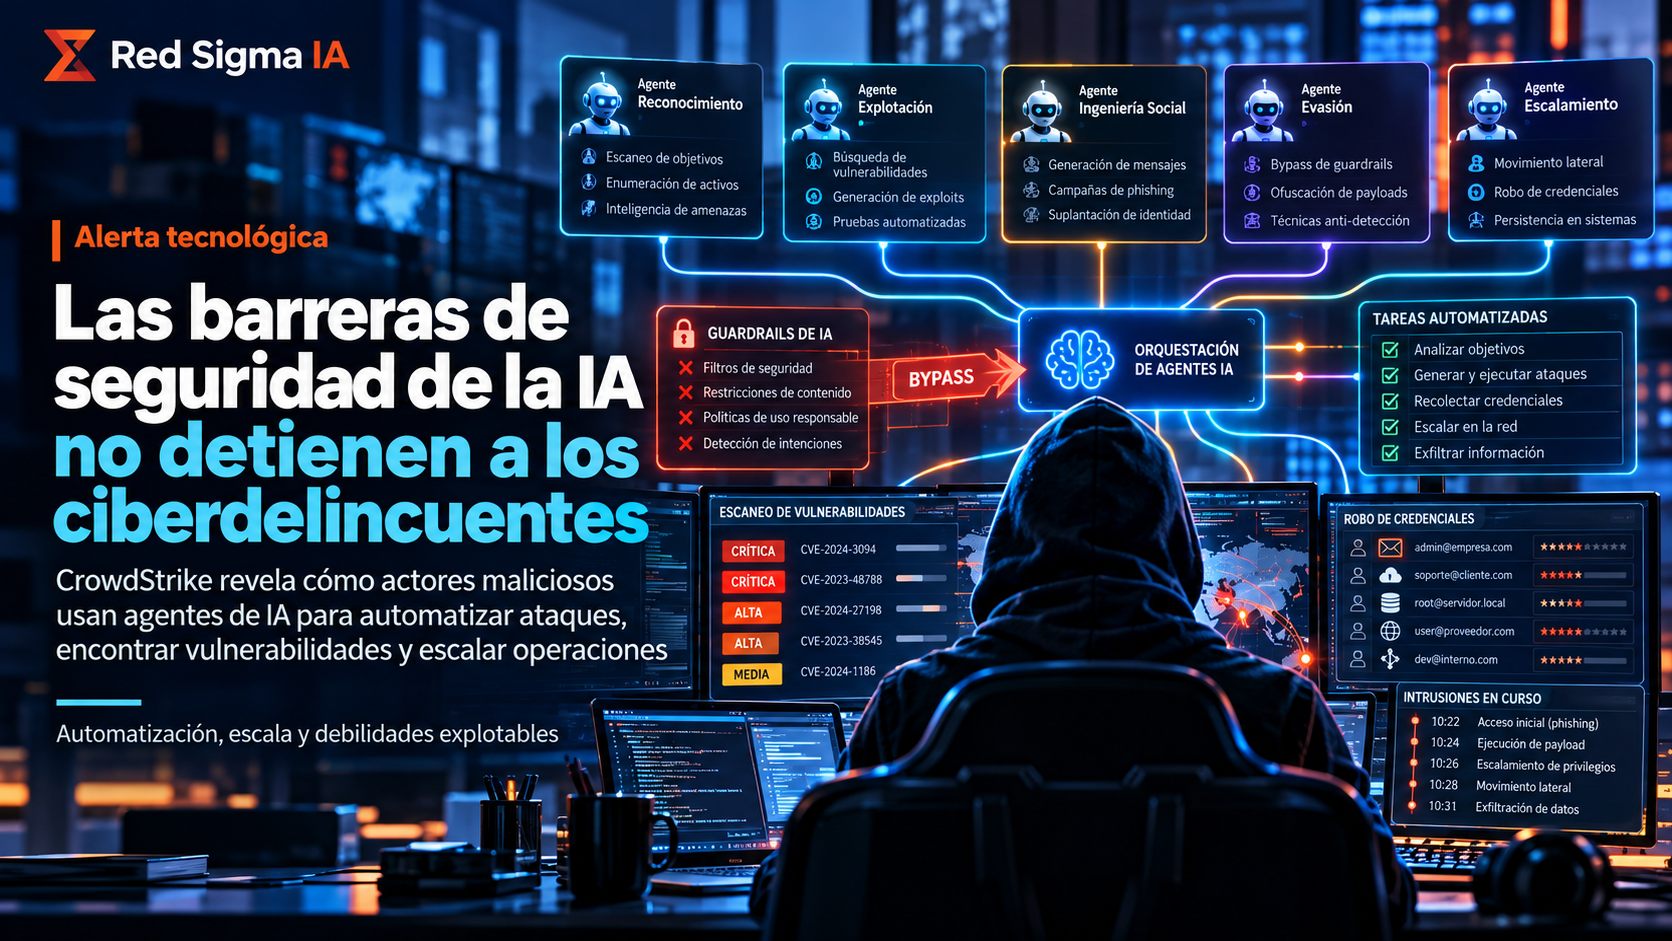
Las barreras de seguridad integradas en los modelos de inteligencia artificial pueden reducir solicitudes peligrosas, pero no constituyen una frontera suficiente contra los grupos criminales. Una investigación de CrowdStrike, difundida por WIRED, analizó la infraestructura de IA utilizada por cuatro actores en campañas realizadas entre mayo y agosto de 2026. Los grupos operaban en chino, español e inglés, indonesio y ruso, y empleaban modelos comerciales, modelos abiertos y herramientas que coordinaban tareas.
El hallazgo no es que un chatbot haya creado por sí solo una campaña perfecta. Es que los atacantes utilizaron agentes como operadores persistentes: escanearon, interpretaron resultados, generaron código, ajustaron instrucciones y repitieron acciones. Algunas barreras fueron rodeadas mediante engaños, solicitudes disfrazadas de pruebas autorizadas o herramientas externas. El resultado práctico es una reducción del trabajo manual necesario para explotar sistemas mal configurados o sin parchear.
El modelo no es toda la operación
Un agente de ataque suele combinar varias piezas: un modelo para razonar o redactar, un arnés para organizar pasos, herramientas para interactuar con sistemas y un operador humano que define objetivos. Si una pieza falla, otra puede continuar. Por eso discutir únicamente qué modelo utilizaron los atacantes puede ocultar el problema más importante: la arquitectura que permitió ejecutar acciones en serie.
Un modelo puede negarse a escribir una instrucción maliciosa, pero un atacante puede pedirle que analice una alerta, revise una configuración, convierta un archivo o escriba una prueba “para un laboratorio”. También puede alternar entre varios modelos y dividir la tarea en partes que parecen inocuas. La defensa no puede depender de detectar una frase concreta en el prompt.
Cuatro grupos, un patrón común
El análisis revisado por WIRED encontró diferencias entre los cuatro actores. Algunos tenían flujos más sofisticados y utilizaban agentes para mantener el contexto durante largas operaciones. Otros empleaban herramientas más simples y públicas. Esa variedad importa: la IA no solo beneficia a grupos avanzados; también puede ayudar a operadores con menos experiencia a repetir tareas de reconocimiento, phishing o desarrollo de malware.
El patrón común es económico. Un agente no se cansa, puede trabajar durante horas y permite que una persona supervise más objetivos. No necesita descubrir una vulnerabilidad inédita para causar daño. Puede encontrar una aplicación sin actualizar, una contraseña expuesta, un servicio de administración abierto o una cuenta con permisos excesivos. La automatización convierte fallas conocidas en oportunidades escalables.
Cómo se esquivan las barreras
Los investigadores describen estrategias que incluyen presentar la actividad como una prueba de penetración, reformular solicitudes, usar herramientas de terceros y separar una cadena maliciosa en pasos aparentemente legítimos. También se observó el uso de modelos con diferentes niveles de protección. Si una plataforma bloquea una instrucción, el operador puede buscar otra que responda de manera más permisiva.
Esto no significa que las barreras sean inútiles. Una negativa puede detener a un usuario inexperto, reducir la calidad de un código malicioso o alertar a un sistema de monitoreo. Pero su efectividad depende del contexto: una IA conectada a un terminal, un repositorio, una nube y un navegador tiene una capacidad de acción muy distinta a un chat aislado.
Los objetivos siguen siendo los de siempre
A pesar de la novedad de los agentes, los resultados buscados se parecen a los de campañas anteriores: acceso inicial, robo de credenciales, movimiento lateral, persistencia, exfiltración y extorsión. La IA acelera la búsqueda y el ajuste; no elimina la necesidad de una entrada. Si una organización tiene MFA, parches, segmentación y monitoreo sólidos, el agente encuentra más obstáculos.
La imagen difundida habla de protecciones que fallan frente a cibercriminales. La respuesta no debe ser abandonar la IA, sino evitar que el atacante tenga una ventaja decisiva por fallas básicas. Una cuenta privilegiada sin MFA, una consola expuesta o una dependencia sin actualizar puede ser más importante que el modelo utilizado por el atacante.
Qué deben reforzar los equipos defensivos
- Identidad: exigir MFA resistente al phishing, limitar privilegios y eliminar cuentas compartidas o abandonadas.
- Superficie expuesta: revisar servicios en internet, consolas, repositorios, APIs y herramientas de administración.
- Telemetría: correlacionar autenticaciones, comandos, descargas, cambios de permisos y conexiones de agentes.
- Velocidad de parcheo: priorizar vulnerabilidades explotables en activos públicos y verificar la instalación real de la corrección.
- Seguridad de herramientas: controlar quién puede conectar modelos a terminales, navegadores, repositorios y nubes.
- Pruebas realistas: evaluar prompt injection, abuso de herramientas, extracción de secretos y acciones encadenadas en entornos aislados.
- Respuesta: preparar revocación de tokens, aislamiento de equipos y búsqueda de persistencia cuando una cuenta sea comprometida.
La supervisión humana debe cambiar
Supervisar un agente no equivale a leer cada mensaje que produce. El equipo debe vigilar decisiones, cambios y resultados: qué activos consultó, qué comandos ejecutó, qué archivos generó y qué información movió. Un registro completo permite reconstruir la cadena de acciones y detectar que una tarea aparentemente normal terminó en un comportamiento no autorizado.
También conviene asignar límites técnicos. Un agente que redacta un reporte no necesita enviar correos; uno que busca vulnerabilidades no necesita publicar código; uno que clasifica alertas no necesita cerrar incidentes ni modificar reglas de firewall. La autorización debe ser específica, temporal y revocable.
Qué significa para los proveedores de modelos
Los proveedores deben mejorar las barreras, la detección de abuso, los límites de herramientas y la colaboración con defensores. Pero no pueden controlar todos los entornos donde se ejecutan sus modelos, especialmente cuando existen versiones abiertas, modelos distilados o sistemas que combinan varios proveedores.
Eso vuelve necesaria una defensa por capas. El proveedor puede rechazar una solicitud peligrosa; la organización debe impedir que el agente toque producción sin aprobación; la plataforma debe registrar la acción; y el equipo de respuesta debe poder cortar el acceso. La seguridad de la IA es una responsabilidad compartida entre modelo, aplicación, infraestructura y usuario.
El riesgo real es la escala
Los cibercriminales no necesitan una inteligencia artificial extraordinaria para causar daños extraordinarios. Les basta con automatizar tareas que ya funcionan contra organizaciones con controles débiles. Un agente que prueba miles de configuraciones, personaliza mensajes y reintenta con paciencia puede generar una presión que los equipos pequeños no logran absorber.
La conclusión defensiva es concreta: no hay que esperar a que aparezca un modelo completamente autónomo. Los controles deben estar listos para ataques que ya combinan automatización y supervisión humana. Si las barreras del modelo fallan, la red, la identidad, la segmentación, el monitoreo y la respuesta deben seguir funcionando.
Fuentes: WIRED — AI Guardrails Aren’t Stopping Criminal Hackers; Anthropic — Countering misuse of AI: September 2026.