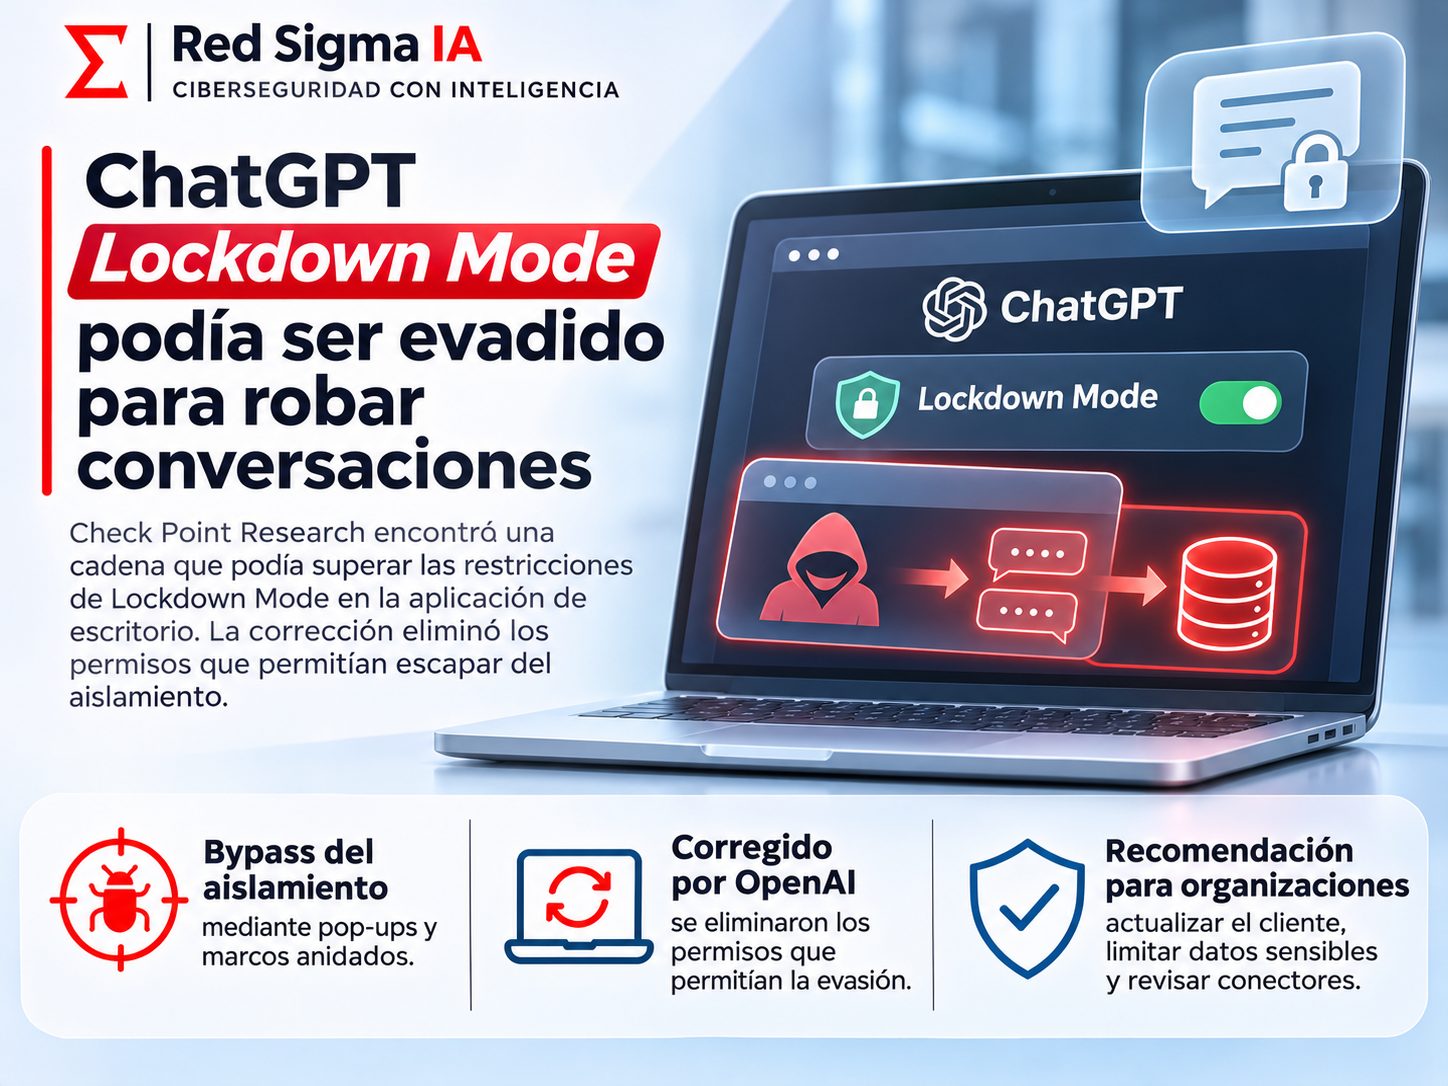
Lockdown Mode fue diseñado para reducir el riesgo de que instrucciones maliciosas escondidas en una conversación provocaran la salida de información sensible. En un entorno de trabajo, esa protección resulta especialmente importante: un usuario puede pegar código privado, documentos, credenciales temporales o datos de clientes en una conversación y no saber que una instrucción indirecta intenta enviarlos a un tercero.
La investigación de Check Point Research mostró que el control no debía analizarse de manera aislada. Aunque la vista previa HTML aplicaba restricciones, una función de ventanas emergentes y la forma en que la aplicación de escritorio componía marcos anidados abrían una ruta alternativa. En el escenario descrito, bastaba con mantener una conversación para activar una cadena capaz de copiar el historial y enviarlo a infraestructura controlada por un atacante.
Qué debía proteger Lockdown Mode
Un modo de bloqueo no intenta convertir ChatGPT en un sistema sin funciones. Su objetivo es limitar caminos de salida: solicitudes de red, contenido activo, enlaces o acciones que podrían transmitir información fuera de la conversación. Esa protección es útil cuando el contenido que el modelo analiza no es confiable, por ejemplo una página web, un archivo recibido por correo o un fragmento de código que contiene instrucciones ocultas.
La dificultad aparece cuando el control se implementa en una capa y la aplicación anfitriona conserva capacidades que esa capa no contempla. El navegador o el contenedor puede permitir crear una ventana, cambiar el contexto de ejecución o comunicarse con un componente que no heredó las mismas restricciones. En lugar de atacar directamente la conversación, el investigador encontró una forma de utilizar el entorno que la mostraba.
La ruta del pop-up y el marco anidado
El análisis técnico describió un HTML-preview sandbox con permisos relacionados con ventanas emergentes. Una página renderizada dentro de ese aislamiento podía crear un marco anidado y alcanzar una función de pop-up sin las restricciones esperadas. Desde allí, el flujo podía interactuar con la ventana principal, simular pantallas y solicitar datos de la sesión.
La lección no consiste en memorizar una técnica de JavaScript. Consiste en entender la diferencia entre “el contenido no puede salir” y “ningún componente del sistema puede crear una ruta de salida”. El segundo requisito es mucho más difícil, porque involucra al renderer, la aplicación de escritorio, el navegador, los permisos del iframe y la relación entre ventanas.
Por qué el ataque podía ser silencioso
Un ataque de exfiltración tradicional suele requerir que la víctima copie información, abra un enlace o descargue un archivo. En la demostración descrita por Check Point, el simple hecho de conversar podía ser suficiente para desencadenar la fuga. Si el contenido malicioso se introducía mediante una página, un GPT o un documento que el modelo procesaba, el usuario podía concentrarse en la respuesta visible mientras una función secundaria trabajaba en segundo plano.
La misma clase de fallo podía utilizarse para mostrar una ventana de inicio de sesión falsa o empujar malware. Una interfaz conocida reduce la sospecha: el usuario reconoce el diseño, ve el logotipo y supone que la solicitud proviene del servicio. Por eso la seguridad de la aplicación debe proteger tanto los datos como la autenticidad de las ventanas que aparecen alrededor de la conversación.
Medidas para organizaciones que usan asistentes de IA
- Actualizar aplicaciones de escritorio: no asumir que una cuenta protegida compensa una versión antigua del cliente.
- Limitar datos sensibles: aplicar clasificación y minimización antes de introducir código, secretos, expedientes o información personal.
- Controlar extensiones y conectores: revisar qué herramientas pueden leer conversaciones o iniciar conexiones externas.
- Supervisar salidas: registrar transferencias, descargas y llamadas a dominios que no formen parte del flujo normal.
- Separar cuentas: usar identidades y espacios distintos para experimentación, desarrollo y operaciones críticas.
- Probar aislamiento: evaluar pop-ups, iframes, ventanas anidadas, enlaces y contenido activo en el cliente que realmente usa la organización.
Qué debe cambiar en la evaluación de seguridad
Las pruebas de un asistente no pueden quedarse en el modelo. Hay que revisar el sistema completo: navegador, aplicación, sandbox, almacenamiento local, extensiones, conectores y permisos de red. Un modelo puede rechazar una solicitud dañina y, aun así, la interfaz que renderiza una respuesta puede abrir un canal no deseado.
También es necesario probar el caso de “cero clic”. La pregunta no es solamente si un usuario puede ser engañado para abrir un enlace, sino si una conversación, un archivo o una respuesta puede activar una acción sin confirmación. En entornos corporativos, la ausencia de interacción visible debe considerarse una señal de alto riesgo.
La corrección no elimina la responsabilidad de los usuarios
OpenAI corrigió la ruta específica comunicada por Check Point, pero las organizaciones deben mantener sus propias barreras. Lockdown Mode es una capa, no una garantía absoluta. La mejor defensa sigue siendo reducir la cantidad de información sensible que llega a una conversación, mantener los clientes actualizados y contar con registros que permitan investigar qué fue leído o transmitido.
El caso resume una idea central para la seguridad de IA: una función de protección puede fallar por una interacción entre componentes aparentemente secundarios. El riesgo no está solo en lo que el modelo responde; también está en lo que el cliente puede hacer con la respuesta y en los permisos que el entorno le concede.
Fuente principal: Check Point Research. La corrección fue comunicada por OpenAI a los investigadores tras la divulgación responsable.